本文详解如何在NVIDIA DGX Spark上利用NemoClaw和Ollama部署本地AI智能体。通过极简脚本一键配置Qwen3.5或DeepSeek-R1等大模型,实现沙盒隔离与隐私保护。文章提供从环境准备、模型拉取、UI访问到模型切换的完整操作步骤,助你释放硬件算力。
在DGX Spark上运行本地AI智能体的最终效果

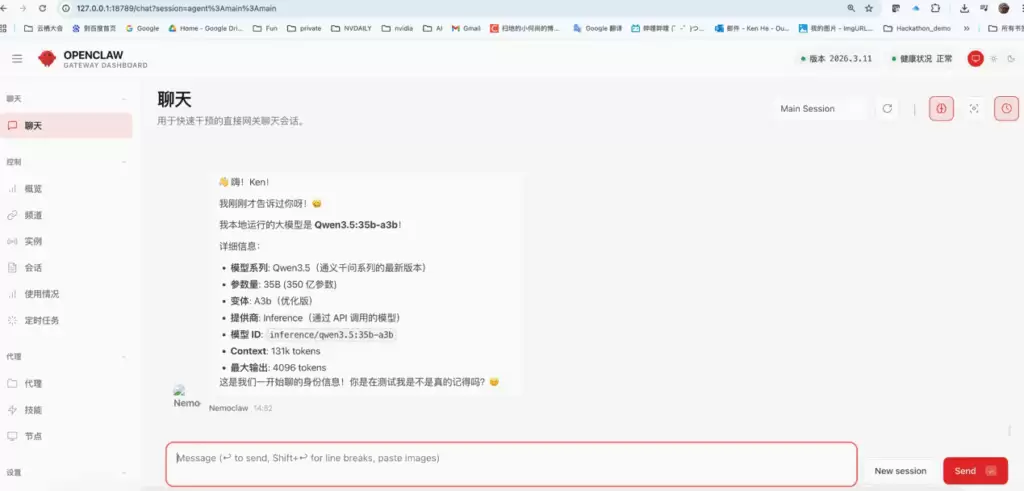
在NVIDIA DGX Spark上成功部署NemoClaw后,你将获得一个极具未来感的Web控制台界面。该界面不仅支持流畅的文本交互,还能自主编写代码、操作文件和控制浏览器。通过本地部署大语言模型(如Qwen3.5或DeepSeek-R1),你可以实现零成本、无限试错的AI智能体体验,同时享受极低的推理延迟和完全本地化的隐私安全。
长期稳定更新的攒劲资源: >>>点此立即查看<<<
为什么选择NemoClaw与DGX Spark组合?
NVIDIA NemoClaw是一个开源软件堆栈,旨在简化运行OpenClaw实时助手的过程。它通过底层的NVIDIA OpenShell运行时,提供了一个更安全、完全隔离的沙盒环境。结合DGX Spark强大的硬件配置(配备GB10 Grace Blackwell超级芯片,拥有1 PFLOPS的算力和128GB的LPDDR5x统一内存),这是释放这台机器潜力的最佳方式。
核心优势:沙盒隔离与隐私路由
- 沙盒隔离:每个AI智能体都在其自身隔离的OpenShell沙盒内运行。通过策略强制控制文件访问、网络活动和数据泄露,且这些控制独立于智能体进程之外,防止恶意提示词注入覆盖安全策略。
- 隐私路由:自动拦截智能体发出的请求,剥离个人身份信息(PII)和凭证等敏感数据,并根据组织的隐私策略将请求路由到本地或外部AI模型。
- 安全能力演进:当智能体学习新技能或尝试安装新工具时,每一项新能力都受到相同的安全策略控制。
本地部署的不可替代性
在DGX Spark上本地运行大模型具有无与伦比的优势:
- 零成本无限试错:复杂的智能体任务(如代码调试、网络信息提取)通常消耗大量Token。本地模型无需担心API账单,让智能体自由工作。
- 压榨硬件潜力:DGX Spark的128GB统一内存和273 GB/s内存带宽可以轻松容纳Qwen3.5 35B或DeepSeek-R1 70B等开源模型,带来极低的推理延迟。
极简部署方案:从环境准备到UI访问
以下操作以在DGX Spark上运行基于本地Qwen3.5 35B模型的安全智能体为例,提供极简的部署步骤。
第1步:准备运行环境
确保你的DGX Spark上已安装Docker,并且Ollama服务已启动。首先,拉取所需的Qwen3.5模型:
- 打开终端。
- 执行以下命令拉取模型:
ollama pull qwen3.5:35b-a3b完成判断:终端显示模型下载完成,无报错信息。
第2步:运行一键部署脚本
克隆辅助脚本并运行它,脚本将自动检测本地Ollama服务并列出已安装的模型。
- 获取辅助部署脚本:
git clone https://github.com/HeKun-NVIDIA/nemoclaw-setup.git
cdemoclaw-setup- 授予执行权限并运行脚本:
bash nemoclaw-setup.sh终端交互指南:
1. 脚本询问是否使用本地Ollama进行推理时,输入 Y 并回车。
2. 列出已安装的模型,输入模型编号(例如 1)并回车。
3. 脚本进入NemoClaw的官方引导流程,询问是否创建或覆盖沙盒时,输入 y 确认创建。
4. 选择推理方法时,输入 3 选择Local Ollama,然后输入第一步中选择的模型名称(例如 qwen3.5:35b-a3b)。
5. 选择策略预设时,直接按回车键应用默认推荐配置(通常包括pypi和npm访问权限)。
完成判断:脚本最后输出以下消息,表明网络路由已成功配置,桥接了沙盒与主机Ollama之间的通信:
Patchinggateway inference route...
 Gateway inference route updated to http://172.17.0.1:11434/v1
─────────────────────────────────────────────────
Browser access:http://127.0.0.1:18789/
─────────────────────────────────────────────────
第3步:远程访问Web UI
假设DGX Spark的IP地址是 192.168.8.117,你想通过MacBook上的浏览器访问UI。在MacBook终端中设置SSH端口转发:
ssh -N -L 18789:127.0.0.1:18789 nvidia@192.168.8.117保持此终端打开。然后打开浏览器,访问部署成功后终端提示的链接(注意:链接中包含Token,请直接复制终端中显示的完整链接):
http://127.0.0.1:18789/#token=ed53e52784cebb810eef349d946aeeca9574c49feb3e15df6852f17473a752b9完成判断:浏览器加载出NemoClaw控制台界面,显示聊天窗口。
与本地智能体交互及模型切换
在聊天界面中,你可以直接向NemoClaw发送指令。为了验证它正在使用指定的本地模型,你可以问它:“你好,NemoClaw,你的本地大模型是什么?”
智能体会回复其底层的大模型名字,例如:
你好 Ken!本地运行的大模型是 Qwen3.5:35b-a3b!现在,你可以开始给它分配各种任务,例如“帮我写一个贪吃蛇网页游戏并运行它”,同时利用DGX Spark带来的推理速度和完全本地化、隐私安全的AI智能体体验。
进阶:如何一键更换模型?
得益于DGX Spark的128GB内存,你可以轻松尝试更大更强的模型,例如DeepSeek-R1 70B。如果你想更换模型,无需手动编辑复杂的配置文件,只需在终端中指定环境变量并重新运行辅助脚本:
- 提前拉取新模型(可选,但推荐):
ollama pull deepseek-r1:70b- 一键切换并重建沙盒:
NEMOCLAW_MODEL=deepseek-r1:70b NEMOCLAW_RECREATE_SANDBOX=1 bash nemoclaw-setup.sh完成判断:辅助脚本会自动销毁旧沙盒,重建它,并配置所有网络路由。几分钟内,你的NemoClaw智能体就会带着新的DeepSeek大脑重新开始。
问题与调整
- 问题:部署脚本运行时提示Ollama未启动或连接失败。
原因:Ollama服务未在后台运行或端口未开放。
解决方法:确保Ollama服务已启动,并检查防火墙设置是否允许本地端口通信。 - 问题:Web UI无法通过SSH端口转发访问。
原因:SSH命令参数错误或DGX Spark IP地址不正确。
解决方法:检查DGX Spark的IP地址,并确保SSH命令中的端口映射正确(-L 18789:127.0.0.1:18789)。
总结
通过NemoClaw和Ollama在NVIDIA DGX Spark上部署本地AI智能体,不仅实现了沙盒隔离与隐私保护,还充分发挥了硬件的算力潜力。从环境准备、模型拉取、UI访问到模型切换,整个过程简洁高效。无论是Qwen3.5还是DeepSeek-R1,DGX Spark都能轻松应对,为你带来极致的本地AI体验。
以上就是NVIDIA DGX Spark部署NemoClaw本地AI智能体的详细内容,更多关于NVIDIA DGX Spark、NemoClaw、本地AI智能体、OpenClaw、Ollama的资料请关注本站其它相关文章!